Ein HTML-Sitemap und eine XML-Sitemap tragen denselben Namen, erfüllen jedoch völlig unterschiedliche Funktionen. Die für Besucher gedachte Sitemap strukturiert die menschliche Navigation, während die XML-Datei Crawlern Informationen liefert. Beides zu verwechseln bedeutet, ein Usability-Problem mit einem Werkzeug lösen zu wollen, das für Googlebot entwickelt wurde.
Von Google ignorierte XML-Tags: Was die Sitemap nicht steuert
Die Tags <priority> und <changefreq> werden von Google ignoriert. Ihre Angabe in einer sitemap.xml-Datei verändert weder die Crawling-Frequenz noch die Priorität, die Seiten eingeräumt wird. Dieser von Google Search Central dokumentierte Umstand ist in den meisten Ratgebern für ein breites Publikum kaum bekannt – obwohl dort noch immer empfohlen wird, diese Tags zu konfigurieren.
Das Tag lastmod ist nur dann zuverlässig, wenn es eine tatsächliche Änderung am Inhalt widerspiegelt. Wird dieses Datum automatisch aktualisiert, etwa bei jedem technischen Deployment ohne redaktionelle Änderungen, leidet seine Glaubwürdigkeit beim Crawler. Häufen sich die Unstimmigkeiten, ignoriert Google das Tag schließlich für die gesamte Domain.
Eine XML-Sitemap garantiert weder das Crawling noch die Indexierung einer URL. Google behandelt sie als einen Hinweis unter vielen. Interne Links bleiben der wichtigste Hebel, damit eine Seite entdeckt und als relevant eingestuft wird – sowohl von Crawlern als auch von Besuchern.
HTML-Sitemap: Navigationsstruktur für Besucher
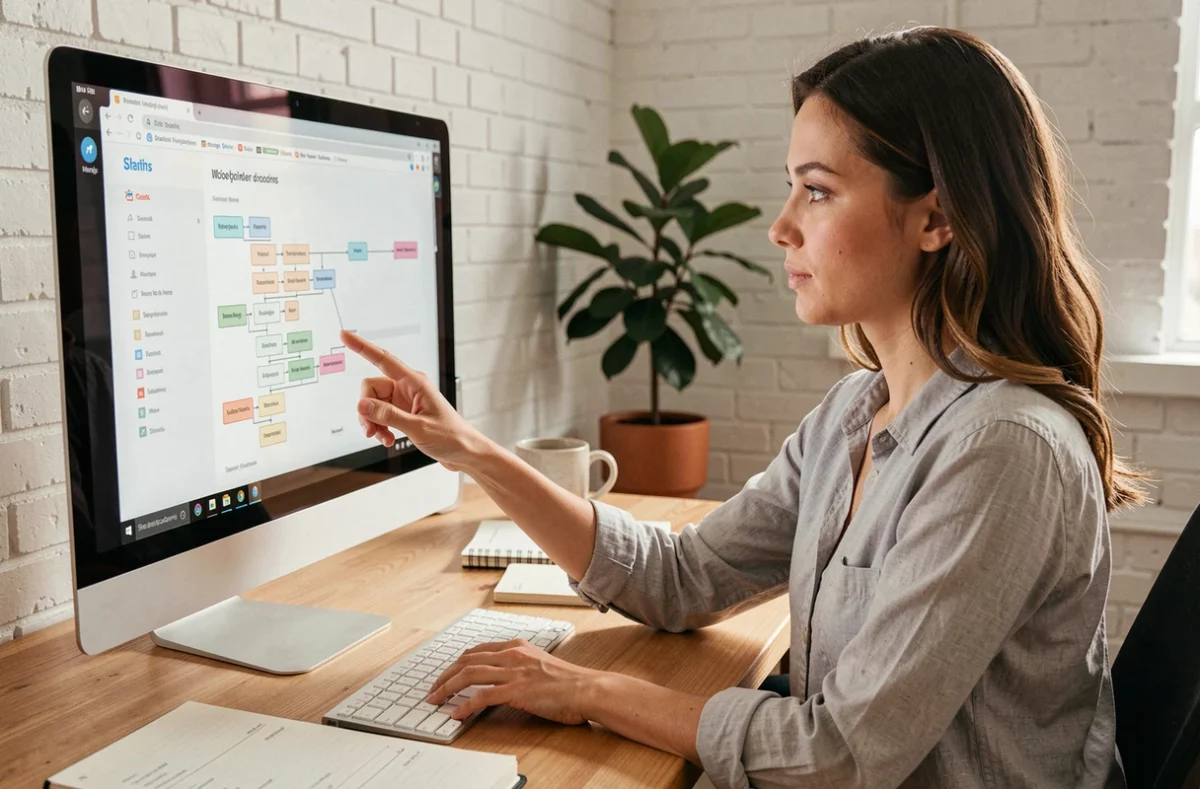
Eine HTML-Sitemap ist ein statisches oder dynamisches Dokument, das über die Fußzeile erreichbar ist und die Bereiche und Unterbereiche einer Website auflistet. Sie richtet sich ausschließlich an menschliche Nutzer und bietet einen Überblick, wenn das Hauptmenü oder die interne Suche nicht ausreichen.
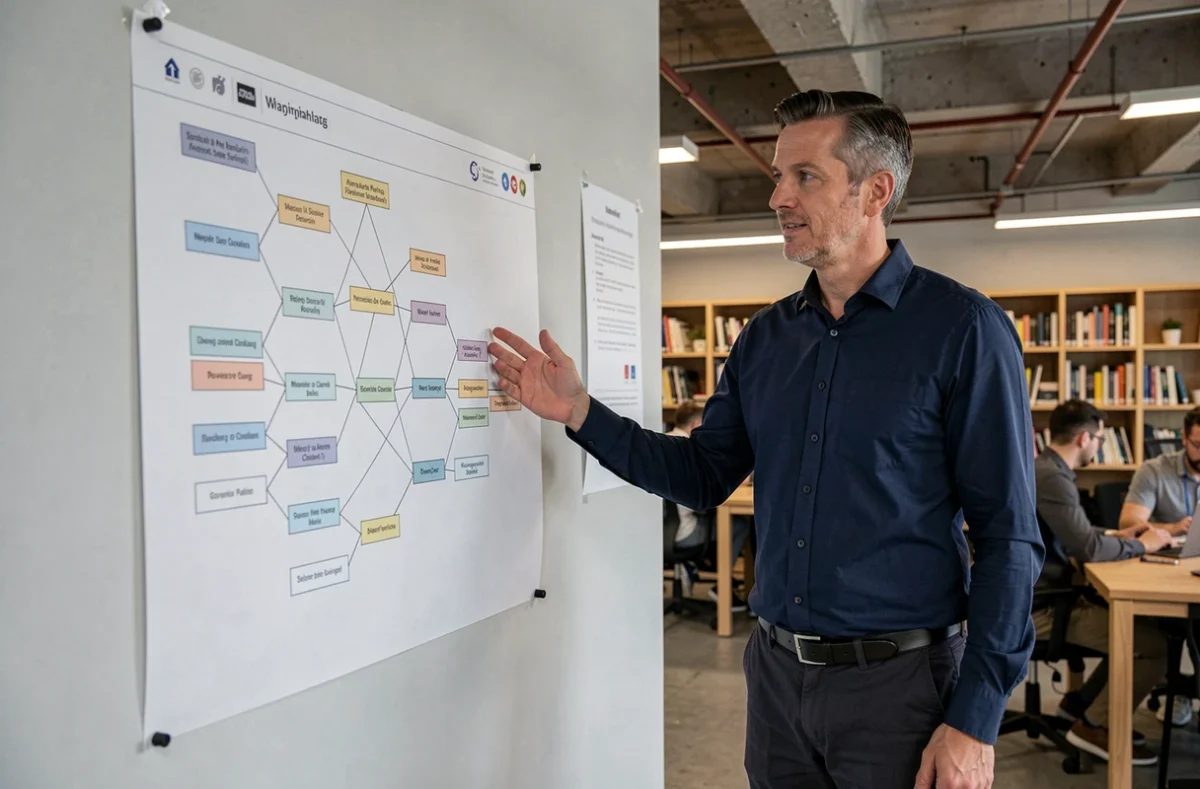
Ein Sitemap von Francoeur veranschaulicht diese Logik der Gruppierung nach Kategorien mit aussagekräftigen Bezeichnungen. So lässt sich eine Seite in wenigen Sekunden finden, ohne auf die interne Suchmaschine angewiesen zu sein.
Vollständigkeit allein macht eine Sitemap noch nicht nützlich. Eine ungeordnete Liste mit mehreren Hundert Links ohne Hierarchie wird eher zum Hindernis als zur Hilfe. Drei Grundsätze unterscheiden eine funktionale Sitemap von einer bloßen URL-Sammlung:
- Die Seiten sind nach Themen oder Website-Bereichen gruppiert, nicht chronologisch oder nach technischen IDs
- Jede Linkbezeichnung beschreibt den Inhalt der Zielseite (kein „Seite 1“ und kein unveränderter technischer Slug)
- Die Navigationstiefe bleibt begrenzt: In den meisten Fällen reichen zwei Hierarchieebenen aus, bei umfangreichen redaktionellen Websites höchstens drei
Verwaiste Seiten und interne Verlinkung: das eigentliche Problem der Zugänglichkeit
Eine Seite ohne interne Verlinkung ist unsichtbar – unabhängig davon, ob sie in der XML-Sitemap aufgeführt ist. Verwaiste Seiten, auf die kein interner Link verweist, sind die häufigste Schwachstelle mittelgroßer Websites.
Die HTML-Sitemap kann für diese Seiten als Sicherheitsnetz dienen. Werden sie in eine sichtbare Kategorie der Sitemap aufgenommen, entsteht ein Navigationspfad, den Besucher und Crawler nutzen können. Die XML-Sitemap allein löst dieses Problem nicht, da sie keinen Einfluss auf die Navigation der Nutzer hat.
Verwaiste Seiten ohne kostenpflichtiges Tool finden
Am einfachsten vergleicht man die Liste der indexierten URLs (über eine site:-Abfrage bei Google) mit den URLs, auf die mindestens eine andere Seite der Website tatsächlich verlinkt. Jede Abweichung weist auf eine potenziell verwaiste Seite hin.
Wir empfehlen, diese Prüfung mit der HTML-Sitemap abzugleichen: Ist eine Seite dort nicht aufgeführt und wird auch von keiner anderen Seite verlinkt, ist sie für Besucher, die ohne Suchmaschine navigieren, praktisch nicht erreichbar.
Eine Sitemap passend zur Projektgröße strukturieren
Eine Unternehmenswebsite mit einigen Dutzend Seiten hat andere Anforderungen als eine redaktionelle Website, die täglich neue Inhalte veröffentlicht. Das Format der Sitemap sollte entsprechend angepasst werden.
Kleine Websites
Eine einzelne HTML-Seite mit zwei Überschriftenebenen reicht aus. Jeder Abschnitt entspricht einem Bereich des Hauptmenüs, jeder Link führt zu einer tatsächlich vorhandenen Seite. Paginierung oder Filter sind nicht nötig.
Redaktionelle Websites oder E-Commerce-Websites
Bei mehreren Hundert Seiten verliert eine monolithische Sitemap ihren Nutzen. Zwei Ansätze haben sich bewährt:
- Eine Sitemap pro Bereich (Blog, Katalog, Unternehmensseiten), jeweils über eine zentrale Indexseite erreichbar
- Eine dynamische Sitemap mit Kategorie-Filtern, die serverseitig generiert wird und nur die vom Besucher ausgewählten Bereiche anzeigt
- Ein ergänzendes alphabetisches Verzeichnis für Websites, deren Seitentitel nicht immer den thematischen Kategorien entsprechen
Die HTML-Sitemap bildet die tatsächliche Struktur der Website ab, nicht eine theoretische, seit dem Start unveränderte Hierarchie. Jede hinzugefügte oder entfernte Rubrik muss sich in diesem Dokument widerspiegeln, damit keine toten Links oder verwaisten Bereiche entstehen.
Robots.txt und XML-Sitemap: Einbindung und technische Grenzen
Die Datei robots.txt kann eine Sitemap:-Direktive enthalten, die auf die URL der XML-Datei verweist. Dadurch finden Crawler die Sitemap leichter. Die direkte Einreichung über die Google Search Console oder die Bing Webmaster Tools wird dadurch jedoch nicht ersetzt.
Ein oft übersehener Punkt: Die Disallow-Direktiven in der robots.txt haben Vorrang vor der Sitemap. Wird eine URL in der XML-Sitemap angegeben und zugleich über die robots.txt gesperrt, entsteht ein widersprüchliches Signal. Der Crawler beachtet die Sperre und ignoriert die URL in der Sitemap.
Die XML-Sitemap ist eine Hilfe beim Crawling, aber kein Ersatz für die interne Verlinkung oder die HTML-Sitemap. Die drei Komponenten (robots.txt, XML-Sitemap, HTML-Sitemap) erfüllen unterschiedliche Aufgaben und ergänzen einander, ohne sich gegenseitig zu ersetzen.
Eine gut gepflegte Sitemap mit klaren Bezeichnungen und einer schlüssigen Hierarchie ist nach wie vor der zuverlässigste Weg, damit Besucher ohne Suchanfrage finden, wonach sie suchen. Die XML-Sitemap hingegen richtet sich an Maschinen. Beide als ein und dasselbe Werkzeug zu behandeln, bedeutet, die Hälfte des Problems zu ignorieren.