Een HTML-sitemap en een XML-sitemap hebben dezelfde naam, maar vervullen totaal verschillende functies. De sitemap voor bezoekers structureert de menselijke navigatie, terwijl het XML-bestand crawlers van informatie voorziet. Die twee met elkaar verwarren is alsof je een probleem met de gebruiksvriendelijkheid probeert op te lossen met een tool die voor Googlebot is ontworpen.
XML-tags die Google negeert: wat de sitemap niet regelt
De tags <priority> en <changefreq> worden door Google genegeerd. Door ze in een sitemap.xml-bestand in te vullen, verandert noch de crawlfrequentie, noch de prioriteit die aan pagina’s wordt toegekend. Dit punt is gedocumenteerd door Google Search Central, maar blijft onbekend bij de meeste algemene gidsen, die nog steeds aanraden deze tags in te stellen.
De tag lastmod is alleen betrouwbaar als deze een daadwerkelijke wijziging in de content weergeeft. Als je deze datum automatisch bijwerkt, bijvoorbeeld bij elke technische implementatie zonder redactionele wijzigingen, tast dat de geloofwaardigheid ervan bij de crawler aan. Als de inconsistenties zich opstapelen, negeert Google de tag uiteindelijk voor het hele domein.
Een XML-sitemap garandeert niet dat een URL wordt gecrawld of geïndexeerd. Google beschouwt de sitemap als een aanwijzing naast andere signalen. Interne links blijven het belangrijkste middel om ervoor te zorgen dat een pagina wordt ontdekt en als relevant wordt beschouwd, zowel door crawlers als door bezoekers.
HTML-sitemap: navigatiestructuur voor bezoekers
Een HTML-sitemap is een statisch of dynamisch document dat bereikbaar is via de footer en de rubrieken en subrubrieken van een website opsomt. De functie is uitsluitend gericht op menselijke gebruikers: een overzicht bieden wanneer het hoofdmenu of de interne zoekfunctie niet volstaat.
Een sitemap van Francoeur laat zien hoe je rubrieken kunt groeperen met duidelijke benamingen. Zo vind je binnen enkele seconden een pagina, zonder afhankelijk te zijn van de interne zoekmachine.
Volledigheid alleen maakt een sitemap nog niet nuttig. Een ongestructureerde lijst met honderden links wordt eerder een obstakel dan een hulpmiddel. Drie principes maken het verschil tussen een functionele sitemap en een simpele dump van URL’s:
- Pagina’s worden gegroepeerd op onderwerp of per websiteonderdeel, niet op chronologische volgorde of technische ID
- Elke linktekst beschrijft de inhoud van de doelpagina (dus geen “Pagina 1” of kale technische slug)
- De navigatiediepte blijft beperkt: in de meeste gevallen volstaan twee hiërarchische niveaus; voor grote redactionele websites zijn er maximaal drie nodig
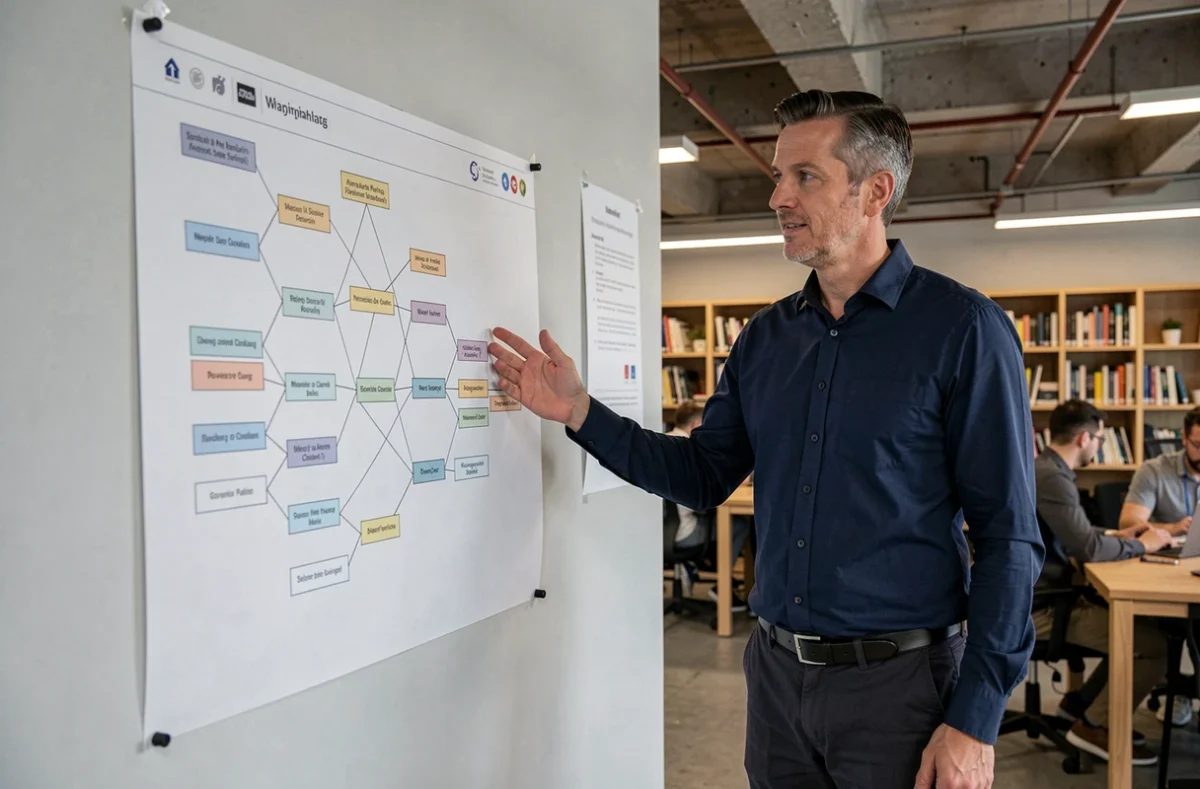
Weespagina’s en interne linkstructuur: het echte toegankelijkheidsprobleem
Een pagina zonder interne links is onzichtbaar, ongeacht of deze in de XML-sitemap staat. Weespagina’s, waarnaar geen enkele interne link verwijst, vormen de meest voorkomende blinde vlek op middelgrote websites.
De HTML-sitemap kan als vangnet voor deze pagina’s dienen. Door ze op te nemen in een zichtbare categorie van de sitemap, creëer je een navigatiepad dat bezoekers en crawlers kunnen volgen. De XML-sitemap alleen lost dit probleem niet op, omdat die geen invloed heeft op de gebruikersnavigatie.
Weespagina’s opsporen zonder betaalde tool
De eenvoudigste methode is om de lijst met geïndexeerde URL’s (via een site:-zoekopdracht in Google) te vergelijken met de URL’s waarnaar vanaf minstens één andere pagina op de website wordt gelinkt. Elk verschil wijst op een mogelijk weespagina.
We raden aan deze controle te combineren met de HTML-sitemap: als een pagina daar niet in staat en er vanaf geen enkele andere pagina naar wordt gelinkt, is deze in de praktijk onbereikbaar voor bezoekers die zonder zoekmachine navigeren.
Een sitemap structureren op basis van de projectomvang
Een bedrijfswebsite met enkele tientallen pagina’s heeft andere vereisten dan een redactionele website die dagelijks nieuwe content publiceert. De vorm van de sitemap moet daarop worden afgestemd.
Kleine websites
Eén HTML-pagina met twee kopniveaus volstaat. Elke sectie komt overeen met een rubriek in het hoofdmenu en elke link verwijst naar een bestaande pagina. Paginering of filters zijn niet nodig.
Redactionele websites of webshops
Bij meer dan enkele honderden pagina’s verliest een monolithische sitemap zijn nut. Twee aanpakken werken goed:
- Een sitemap per onderdeel (blog, catalogus, institutionele pagina’s), elk bereikbaar via een centrale indexpagina
- Een dynamische sitemap met filters per categorie, gegenereerd aan de serverzijde, die de weergave beperkt tot de rubrieken die de bezoeker selecteert
- Een aanvullende alfabetische index voor websites waarvan de paginatitels niet altijd overeenkomen met de thematische categorieën
De HTML-sitemap weerspiegelt de werkelijke structuur van de website, niet een theoretische boomstructuur die bij de lancering is vastgelegd. Elke toevoeging of verwijdering van een rubriek moet in dit document worden verwerkt, om dode links of lege secties te voorkomen.
Robots.txt en XML-sitemap: verwijzing en technische beperkingen
Het robots.txt-bestand kan een Sitemap:-directive bevatten die verwijst naar de URL van het XML-bestand. Deze verwijzing helpt crawlers de sitemap te vinden, maar vervangt niet de rechtstreekse indiening via Google Search Console of Bing Webmaster Tools.
Een punt dat vaak over het hoofd wordt gezien: Disallow-directives in robots.txt hebben voorrang op de sitemap. Een URL opnemen in de XML-sitemap en deze tegelijk blokkeren via robots.txt geeft tegenstrijdige signalen. De crawler respecteert de blokkade en negeert de URL in de sitemap.
De XML-sitemap blijft een hulpmiddel voor crawling, geen vervanging voor interne links of de HTML-sitemap. De drie onderdelen (robots.txt, XML-sitemap, HTML-sitemap) hebben elk een eigen functie en vullen elkaar aan, maar vervangen elkaar niet.
Een goed onderhouden sitemap met duidelijke benamingen en een logische hiërarchie blijft de betrouwbaarste manier om bezoekers te helpen vinden wat ze zoeken, zonder dat ze een zoekopdracht hoeven in te voeren. De XML-sitemap is er voor machines. Beide als één en hetzelfde hulpmiddel behandelen, betekent dat je de helft van het probleem negeert.