Um mapa do site HTML e um sitemap XML partilham o mesmo nome, mas as suas funções são radicalmente diferentes. O mapa do site destinado aos visitantes organiza a navegação humana, enquanto o ficheiro XML alimenta os robôs de indexação. Confundi-los é como tentar resolver um problema de usabilidade com uma ferramenta concebida para o Googlebot.
Etiquetas XML ignoradas pelo Google: o que o sitemap não controla
As etiquetas <priority> e <changefreq> são ignoradas pelo Google. Preenchê-las num ficheiro sitemap.xml não altera nem a frequência de rastreamento nem a prioridade atribuída às páginas. Este facto, documentado pelo Google Search Central, continua a ser desconhecido para a maioria dos guias generalistas, que ainda recomendam configurá-las.
A etiqueta lastmod só é fiável se refletir uma alteração real no conteúdo. Atualizar esta data automaticamente, por exemplo, a cada implementação técnica sem alterações editoriais, reduz a sua credibilidade aos olhos do crawler. Se as inconsistências se multiplicarem, o Google acaba por ignorá-la em todo o domínio.
Um sitemap XML não garante o rastreamento nem a indexação de um URL. O Google trata-o como um indício entre vários. Os links internos continuam a ser o principal meio para que uma página seja descoberta e considerada relevante, tanto pelos robôs como pelos visitantes.
Mapa do site HTML: arquitetura de navegação para os visitantes
O mapa do site HTML é um documento estático ou dinâmico, acessível a partir do rodapé, que lista as secções e subseções do site. A sua função é estritamente orientada para o utilizador: oferecer uma visão geral quando o menu principal ou a pesquisa interna não são suficientes.
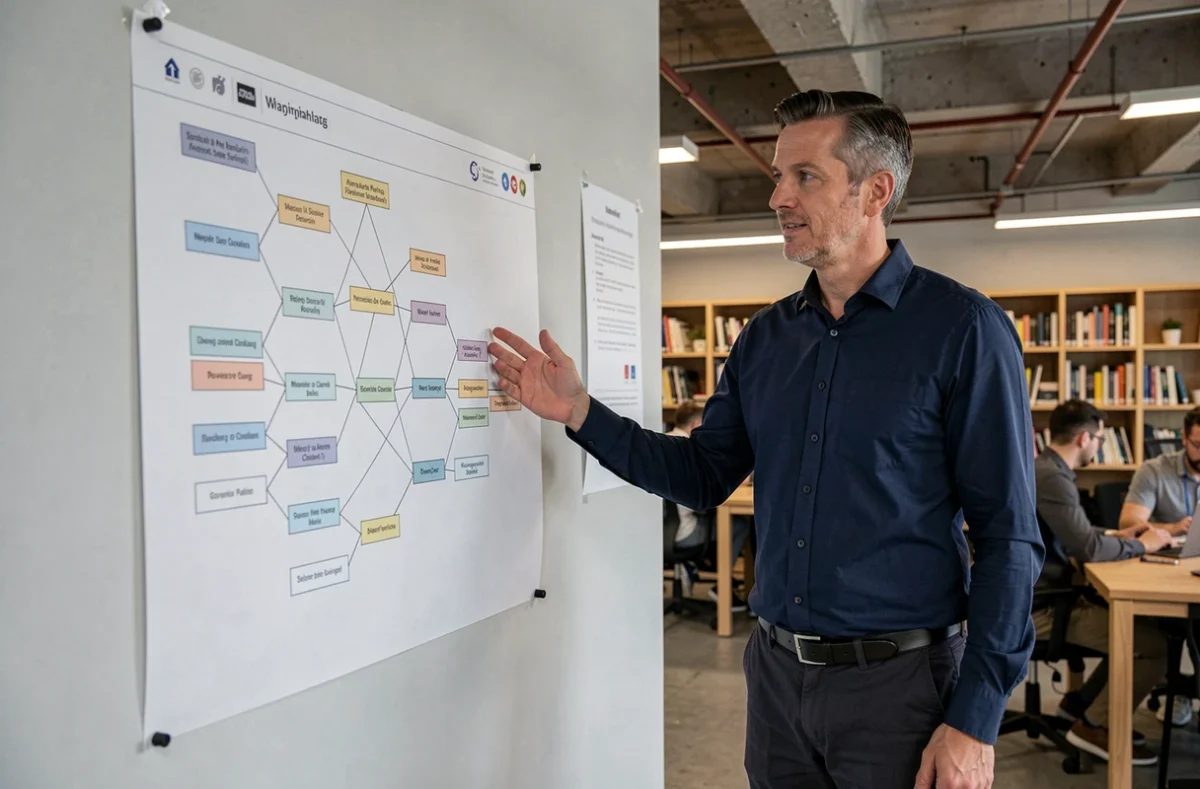
Um mapa do site Francoeur ilustra esta lógica de agrupamento por categorias com títulos explícitos, permitindo localizar uma página em poucos segundos sem depender do motor de pesquisa interno.
A completude, por si só, não torna um mapa do site útil. Uma lista simples com centenas de links e sem hierarquia torna-se um obstáculo, em vez de uma ajuda. Três princípios distinguem um mapa do site funcional de uma mera lista de URLs:
- As páginas são agrupadas por tema ou secção do site, e não por ordem cronológica nem por identificador técnico
- O texto de cada link descreve o conteúdo da página de destino (nada de «Página 1» ou de slugs técnicos em bruto)
- A profundidade de navegação é limitada: dois níveis hierárquicos são suficientes na maioria dos casos; três, no máximo, para sites editoriais de grande dimensão
Páginas órfãs e links internos: o verdadeiro problema de acessibilidade
Uma página sem links internos é invisível, independentemente da sua presença no sitemap XML. As páginas órfãs, ou seja, aquelas para as quais não aponta nenhum link interno, são o ponto cego mais frequente em sites de média dimensão.
O mapa do site HTML pode servir de rede de segurança para estas páginas. Ao incluí-las numa categoria visível do mapa, cria-se um percurso de navegação que o visitante e o robô podem seguir. O sitemap XML, por si só, não resolve este problema, uma vez que não influencia a navegação do utilizador.
Identificar páginas órfãs sem ferramentas pagas
O método mais direto consiste em comparar a lista de URLs indexados (através de uma pesquisa site: no Google) com os URLs efetivamente ligados a partir de pelo menos outra página do site. Qualquer discrepância indica uma página potencialmente órfã.
Recomendamos cruzar esta verificação com o mapa do site HTML: se uma página não constar do mapa e não estiver ligada a partir de nenhuma outra página, é, na prática, inacessível para quem navega sem recorrer a um motor de pesquisa.
Estruturar um mapa do site de acordo com a dimensão do projeto
Um site institucional com algumas dezenas de páginas não tem as mesmas necessidades que um site editorial que publica diariamente. O formato do mapa do site deve adaptar-se.
Sites de pequena dimensão
Uma única página HTML com dois níveis de títulos é suficiente. Cada secção corresponde a uma rubrica do menu principal e cada link aponta para uma página existente. Não são necessários paginação nem filtros.
Sites editoriais ou de comércio eletrónico
Acima de algumas centenas de páginas, um mapa do site monolítico perde a sua utilidade. Duas abordagens funcionam:
- Um mapa do site por secção (blogue, catálogo, páginas institucionais), cada um acessível a partir de uma página de índice central
- Um mapa do site dinâmico com filtros por categoria, gerado no servidor, que limita a apresentação às secções selecionadas pelo visitante
- Um índice alfabético complementar para sites cujos títulos de página nem sempre correspondem às categorias temáticas
O mapa do site HTML reflete a estrutura real do site, e não uma árvore teórica definida no lançamento. Cada adição ou remoção de uma secção deve refletir-se neste documento, para evitar links quebrados ou secções fantasma.
Robots.txt e sitemap XML: declaração e limites técnicos
O ficheiro robots.txt pode conter uma diretiva Sitemap: que aponta para o URL do ficheiro XML. Esta declaração facilita a descoberta do sitemap pelos robôs, mas não substitui o envio direto através do Google Search Console ou do Bing Webmaster Tools.
Um aspeto frequentemente ignorado: as diretivas Disallow do robots.txt prevalecem sobre o sitemap. Declarar um URL no sitemap XML e, ao mesmo tempo, bloqueá-lo através do robots.txt gera sinais contraditórios. O robô respeita o bloqueio e ignora o URL indicado no sitemap.
O sitemap XML continua a ser uma ferramenta de apoio ao rastreamento, não um substituto dos links internos nem do mapa do site HTML. Os três componentes (robots.txt, sitemap XML, mapa do site HTML) desempenham funções distintas e complementam-se, sem se substituírem.
Um mapa do site bem mantido, com títulos claros e uma hierarquia coerente, continua a ser a forma mais fiável de ajudar um visitante a encontrar o que procura sem ter de fazer uma pesquisa. O sitemap XML, por sua vez, comunica com as máquinas. Tratar ambos como se fossem a mesma ferramenta é ignorar metade do problema.